התשובה הקצרה: בדיקת JavaScript SEO בחנות איקומרס אינה מסתיימת בכך שהעמוד נראה תקין בדפדפן. צריך להשוות שלוש תמונות מצב: ה־HTML שחזר מהשרת, ה־DOM לאחר ש־JavaScript רץ, והמצב שנוצר רק אחרי פעולה של המשתמש. מוצר, קישור, מחיר או נתון מובנה שקיימים רק בתמונה השלישית עלולים להיות נגישים לקונה אך לא להוות בסיס יציב לגילוי ולאינדוקס.
JavaScript אינו בעיית SEO בפני עצמו. הוא מאפשר בחירת וריאנט, סינון, חיפוש, טעינת המלצות ועדכון סל בלי רענון מלא. הכשל מתחיל כאשר מידע מסחרי חיוני תלוי ברצף תנאים שלא תמיד מתקיים: סקריפט נטען, API עונה בזמן, אין שגיאת runtime, המשתמש מבצע פעולה, ורק אז מופיעים הקישור או הנתון. לכן האבחון צריך לעקוב אחרי הנתיב שבו המידע נוצר, ולא אחרי הטכנולוגיה שבה האתר נבנה.
שלוש תמונות מצב במקום שאלה אחת
Google מתארת עיבוד של עמודי JavaScript בשלושה שלבים: סריקה, רינדור ואינדוקס. עבור צוות איקומרס שימושי יותר לתרגם את התהליך לשלוש תמונות מצב שאפשר להשוות בפועל.
| תמונה | מה בודקים | מה היא יכולה לחשוף |
|---|---|---|
| תגובת השרת | קוד הסטטוס וה־HTML לפני הרצת JavaScript | מעטפת ריקה, canonical שגוי, noindex, היעדר תוכן או קישורים |
| DOM מרונדר | המסמך לאחר שהסקריפטים והבקשות החיוניות הסתיימו | תוכן שלא נוסף, שגיאת JavaScript, משאב חסום או structured data חסר |
| אחרי אינטראקציה | מה מופיע רק אחרי בחירת צבע, לחיצה על ״טען עוד״ או פתיחת רכיב | מוצרים, מחיר או זמינות שאין להם מצב נגיש ללא פעולה אנושית |
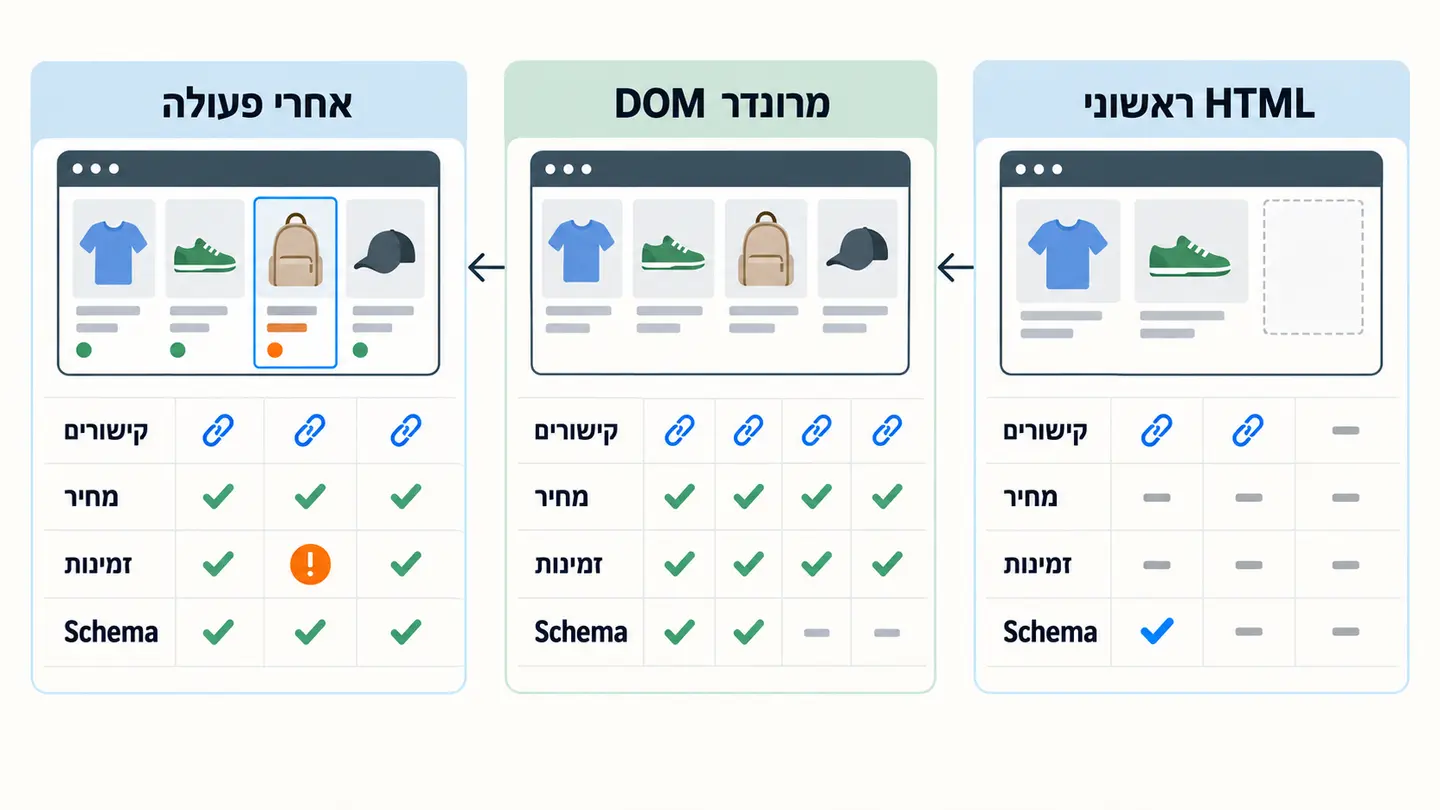
הפער בין התמונות הוא הממצא. אם שם המוצר והקישור נמצאים כבר בתגובת השרת, JavaScript יכול לשפר את החוויה בלי להיות שער הגילוי היחיד. אם הם מופיעים רק ב־DOM המרונדר, נדרש לוודא שרינדור אמין ושמשאבים אינם חסומים. אם הם נוצרים רק אחרי פעולה, צריך לבנות נתיב חלופי ויציב למידע שאמור להיות ניתן לגילוי.
עמוד שעובד אצלכם אינו הוכחה ש־Google קיבלה אותו
הדפדפן של מנהל האתר מגיע עם cache, עוגיות, חיבור מהיר והרשאות רגילות. ייתכן שהוא מציג קטלוג מלא בזמן שבתגובה הראשונית יש רק שלד טעינה. Googlebot מבקש את ה־URL, בודק את קוד התגובה ואת כללי הסריקה, מאתר קישורים ב־HTML ומעביר עמודים לרינדור. לפי Google, רינדור יכול להתעכב; בנוסף, לא כל בוט או מערכת שאוספת מידע מרנדרים JavaScript באותה צורה.
גם רינדור מוצלח פעם אחת אינו מוכיח אמינות. API עלול להחזיר 401, 403, 429 או 500 רק לחלק מהבקשות. קובץ JavaScript חדש יכול להיות מוגש לצד HTML ישן. רכיב עשוי לעבוד למשתמש חוזר בגלל cache ולהיכשל בבקשה נקייה. במצב כזה Search Console יכולה להציג דפוס לא עקבי, והבעיה תיראה כמו ״Google לא מבינה את האתר״ אף שהשורש הוא תלות תפעולית שבירה.
הבדיקה מתחילה אפוא בשאלה מדויקת: איזה מידע חייב להיות יציב גם כאשר שלב משלים נכשל? בחנות, התשובה כוללת בדרך כלל שם מוצר, קישור אמיתי לעמוד, מחיר וזמינות שמוצגים לקונה, canonical, robots, נתוני Product וקוד סטטוס שמשקף את מצב העמוד.
מפת האלמנטים: מה צריך להופיע ובאיזה שלב
לא כל רכיב צריך להישלח מהשרת. פתיחת גלריה, אנימציה, חישוב משלוח אינטראקטיבי והמלצה אישית יכולים להישאר בצד הלקוח. לעומתם, מידע שקובע מהו ה־URL, מה נמכר ולאן אפשר להמשיך דורש רמת אמינות גבוהה יותר.
| אלמנט | מצב מועדף | סיכון אם הוא תלוי רק בפעולה |
|---|---|---|
| קישור למוצר | <a href="/products/..."> בתגובה או ב־DOM המרונדר | המוצר ניתן למציאה דרך חיפוש פנימי אך לא דרך זחילת הקטגוריה |
| שם ותיאור מוצר | טקסט נגיש ביציאה הראשונית או לאחר רינדור יציב | עמוד דק או ריק כשבקשת הנתונים נכשלת |
| מחיר וזמינות | מצב ברירת המחדל תואם לעמוד, ל־Product data ולפיד | Google והקונה מקבלים מצבים שונים או מיושנים |
| canonical ו־robots | עקביים כבר ב־HTML הראשוני | JavaScript מחליף אות קנוני או מוסיף noindex מאוחר מדי או באופן לא עקבי |
| structured data | תואם למידע הגלוי; עדיף נתיב אמין במיוחד לנתונים משתנים | JSON-LD נוצר מאוחר, כפול או עם מחיר שאינו זה שמופיע בעמוד |
| מוצרים נוספים ברשימה | לכל מקטע URL וקישורים שניתנים לגילוי | המשך הקטלוג קיים רק אחרי גלילה או לחיצה |
המפה אינה הוראה לבצע server-side rendering לכל פיקסל. היא כלי תעדוף. ככל שהאלמנט משפיע יותר על זהות העמוד, על גילוי מוצר או על הבטחה מסחרית, כך פחות נכון לתלות אותו באינטראקציה או בבקשת API שאין לה fallback.
קישורים, קטגוריות וטעינה נוספת
Google ממליצה להשתמש בקישורי <a> עם href שניתן לפענוח. ניווט באמצעות onclick, אלמנט span או כתובת javascript: אינו תחליף טוב לקישור. אפשר להוסיף קישור ל־DOM באמצעות JavaScript, אך אז צריך לוודא שהוא אכן מופיע ב־HTML המרונדר.
הבעיה נפוצה ברשתות מוצרים. שמונה הכרטיסים הראשונים מגיעים מהשרת, היתר נטענים לאחר גלילה. למשתמש הכול נראה כרשימה אחת, אבל אם לכל מקטע אין URL קבוע וקישור עוקב, המוצרים המאוחרים תלויים בפעולה ש־Googlebot בדרך כלל אינו מבצע. Sitemap או Merchant Center feed יכולים לעזור לגלות URL, אך הם אינם מתקנים היררכיה שבה המוצר אינו מקושר מתוך הקטלוג.
את ההחלטה אילו גרסאות של קטגוריה צריכות להיות באינדקס מנהלים בנפרד. מדריך אינדוקס הקטגוריות עוסק בכוונת חיפוש, פילטרים ו־canonical; כאן הבדיקה צרה יותר: האם הקישורים והמוצרים שהחלטנו לחשוף קיימים במצב שזחלן יכול להגיע אליו.
מחיר, זמינות ו־Product data חייבים לתאר אותו מצב
Google יכולה לעבד structured data שנוצר באמצעות JavaScript כאשר הוא נמצא ב־DOM המרונדר. עם זאת, בתיעוד הרשמי שלה היא מזהירה ש־Product markup דינמי עלול להפוך סריקות Shopping לפחות תכופות ופחות אמינות, בעיה משמעותית כשמחיר וזמינות משתנים במהירות. זו אינה אמירה שכל JSON-LD דינמי פסול. היא כן סיבה לבחון את שרשרת הנתונים ואת קצב השינוי.
נניח שעמוד מוצר נפתח בווריאנט כחול במחיר 299 ש״ח. ה־HTML הראשוני מכיל structured data של הווריאנט השחור ב־249 ש״ח. אחרי hydration המחיר הגלוי מתעדכן, ואחרי בחירת מידה מתעדכנת הזמינות. שלושת המצבים תקינים מבחינה תחבירית, אבל אינם מתארים אותה הצעה. הפתרון אינו להוסיף עוד script. מגדירים מצב ברירת מחדל אחד, מקור אמת ושדה זהות שמחבר בין הווריאנט, המחיר, הזמינות וה־URL.
ב־Shopify, Theme ואפליקציות יכולים להוסיף או לשנות JSON-LD, רכיבי בחירה ותוכן. לכן בדיקת SEO בחנות Shopify צריכה להשוות את הפלט בפועל, לא להסתפק בהנחה שהפלטפורמה מטפלת בכל אות. אם שתי אפליקציות מוסיפות Product markup, תקינות של כל בלוק בנפרד אינה פותרת סתירה ביניהם.
חמישה מצבי כשל שנראים מבחוץ כמו אותה בעיה
״Google לא רואה את המוצר״ הוא סימפטום, לא אבחנה. מסגרת העבודה שלי מפרידה בין חמישה סוגי כשל:
- כשל גילוי: ה־URL קיים ועובד, אך אין אליו קישור שניתן לסריקה מתוך מבנה האתר.
- כשל רינדור: הסקריפט, המשאב או בקשת הנתונים נכשלים, ולכן התוכן אינו מגיע ל־DOM ש־Google קיבלה.
- כשל מצב: המידע החשוב מופיע רק אחרי בחירה, גלילה, התחברות או פעולה אחרת.
- כשל זהות: status, canonical, robots, URL, structured data והתוכן הגלוי מתארים עמודים או מוצרים שונים.
- כשל אמינות: הכול עובד בבדיקה אחת אך נכשל לסירוגין בגלל timeout, rate limit, cache, גרסה לא תואמת או תלות בשירות חיצוני.
ההפרדה משנה את התיקון. sitemap יכול לעזור בגילוי אך אינו פותר רינדור ריק. server-side rendering יכול לספק תוכן ראשוני אך אינו מתקן canonical שגוי. המתנה ארוכה יותר בכלי בדיקה יכולה להסתיר בעיית אמינות במקום לפתור אותה.
דוגמה: קטגוריה עם ״טען עוד״ ובחירת וריאנט
נניח שקטגוריית תיקי גב מציגה 24 מוצרים. תגובת השרת כוללת כותרת, טקסט קטגוריה ושישה placeholders. לאחר JavaScript נטענים 12 כרטיסים. לחיצה על ״טען עוד״ מוסיפה את 12 המוצרים הנותרים. בכל כרטיס, בחירת צבע משנה תמונה ומחיר, אך הקישור עצמו בנוי על אירוע לחיצה ולא על href.
בתמונה הראשונה אין קישורי מוצר. בתמונה השנייה יש כרטיסים, אך הניווט עדיין אינו קישור תקני. בתמונה השלישית מופיעים כל המוצרים, אך רק אחרי פעולה. לכן אין כאן בעיה אחת. יש כשל גילוי בקישורים, כשל מצב במוצרים המאוחרים וסיכון זהות אם המחיר והווריאנט שנבחרו אינם משתקפים ב־URL וב־Product data.
היישום הסביר יכול להשאיר את חוויית ״טען עוד״, אבל להוסיף רצף עמודים עם כתובות קבועות וקישורים עוקבים. כל כרטיס מקבל <a href> אמיתי. המצב הראשוני מציג מוצר וברירת מחדל עקביים, ופעולת הצבע משפרת את החוויה בלי להיות הדרך היחידה לגלות את המוצר. זו דוגמה היפותטית שנועדה להראות את סדר האבחון, לא תיאור של חנות או תוצאה שהושגה.
Workflow אבחון שאפשר להעביר בין SEO לפיתוח
- בוחרים מדגם תבניות: דף בית, קטגוריה, מוצר עם וריאנטים, מוצר חסר ותוצאה פנימית. לא מסיקים מ־URL יחיד.
- מתעדים את ה־URL והמצב: מכשיר, שוק, שפה, מלאי, וריאנט וסטטוס התחברות. אחרת אי אפשר לשחזר פער.
- שומרים את תגובת השרת: קוד HTTP, title, canonical, robots, H1, טקסט, קישורים ו־JSON-LD.
- בודקים DOM מרונדר: משווים את אותם שדות אחרי שהעמוד סיים לטעון ומחפשים שגיאות console או בקשות שנכשלו.
- מבצעים פעולה מרכזית: בחירת וריאנט, סינון או טעינה נוספת, ומתעדים מה השתנה ב־URL, בתוכן ובנתונים המובנים.
- בודקים עם כלי Google: Rich Results Test ו־URL Inspection מאפשרים לראות פלט מרונדר, משאבים ושגיאות. בדיקה מקומית אינה מחליפה אותם.
- משווים זהות: ה־URL הקנוני, המוצר, הווריאנט, המחיר והזמינות צריכים לספר סיפור אחד בכל שכבה רלוונטית.
- חוזרים על הבדיקה: לפחות בכמה URLs ומועדים. כשל לסירוגין לא מתגלה בדגימה בודדת.
- מסווגים את שורש הבעיה: גילוי, רינדור, מצב, זהות או אמינות.
- מתקנים מדגם ומרחיבים רק אחרי QA: שינוי תבנית משפיע על אלפי URLs, ולכן שומרים דרך חזרה ומודדים לפני הרחבה.
מתי צריך רינדור שרת, ומתי לא
רינדור שרת או pre-rendering הם פתרונות טובים כאשר התוכן הראשי מגיע מאוחר, כאשר ה־API אינו אמין מספיק, או כאשר יש צורך לספק status ו־metadata נכונים כבר בתגובה. הם גם יכולים לשפר את זמן הצגת התוכן למשתמש. אבל מעבר ארכיטקטורה אינו הצעד הראשון בכל תקלה.
אם הבעיה היא קישור onclick, אפשר לתקן את ה־markup בלי להחליף framework. אם structured data כפול, צריך לקבוע בעלות ולהסיר מקור אחד. אם המוצר המאוחר נגיש בעמודים מקושרים, אפשר להשאיר שכבת infinite scroll כחוויית משתמש. ואם תוכן אישי אינו אמור להיכלל באינדקס, אין סיבה לשלוח אותו מהשרת רק כדי שיופיע ב־source.
הכלל המעשי: מעבירים לנתיב אמין ומוקדם את המידע שקובע גילוי, זהות והבטחה מסחרית. אינטראקציה, התאמה אישית ושיפור חווייתי יכולים להישאר בצד הלקוח כל עוד כשל שלהם אינו מוחק את משמעות העמוד.
איך יודעים שהתיקון עבד
בדיקה טכנית תקינה היא תנאי, לא תוצאה עסקית. ברמת ה־URL מאמתים status, canonical, robots, תוכן וקישורים בשלוש תמונות המצב. ברמת Search Console עוקבים אחר אינדוקס, שגיאות, גילוי וביצועים לאורך זמן. ב־Merchant Center בודקים אם מחיר, זמינות ופריטים מושפעים חזרו למצב תקין. בלוגים או דוחות client-side analytics אינם מקור מלא לפעילות Googlebot, כפי ש־Google עצמה מציינת.
שער השחרור צריך לכלול גם תרחיש כשל: API איטי, JavaScript חסום, מוצר שאינו קיים, וריאנט שאזל וחזרה עם כפתור Back. עמוד מוצר חסר צריך להחזיר 404 אמיתי או פתרון ש־Google מתעדת למניעת soft 404, ולא מעטפת 200 עם הודעת שגיאה. כאשר מחליפים קבצי JavaScript, filenames עם fingerprint עוזרים למנוע מצב שבו HTML חדש פוגש cache ישן.
במערכת גדולה, עבודת SEO לאיקומרס טובה אינה מסתיימת ברשימת תקלות. היא מחברת כל ממצא לתבנית, לבעלים, להיקף URLs, לרמת סיכון ולבדיקת קבלה. כך נמנעים משכתוב יקר של frontend כאשר הכשל נמצא בקישור אחד, ומצד שני לא מסתפקים בתיקון נקודתי כשהבעיה נמצאת בחוזה הנתונים של כל הקטלוג.
מה לא לעשות אחרי שמוצאים פער
- לא להסיק ש־JavaScript הוא הבעיה רק מפני שעמוד אינו מאונדקס; קודם בודקים גילוי, status, canonical, robots ואיכות העמוד.
- לא להשתמש ב־dynamic rendering כפלסטר קבוע. Google מתארת אותו כפתרון עוקף ולא כאסטרטגיה מועדפת לטווח ארוך.
- לא לשנות canonical או noindex בצד הלקוח לערך שסותר את ה־HTML הראשוני.
- לא להכניס את כל הקטלוג לתגובת השרת אם רובו אינו נדרש לעמוד; בונים נתיב גילוי, לא payload חסר גבול.
- לא להכריז על הצלחה אחרי צילום מסך אחד ב־URL Inspection. מאמתים כמה תבניות, מצבי מלאי ומועדים.
המטרה אינה לבנות חנות בלי JavaScript. המטרה היא להבטיח שגם כאשר שכבה דינמית משתנה או נכשלת, Google והקונה עדיין מקבלים עמוד בעל זהות ברורה, מידע מסחרי עקבי ודרך אמיתית להגיע למוצרים.
מקורות ובדיקה
המקורות נבדקו בעת העדכון האחרון. קישורים חיצוניים נפתחים באתר המקור.
- Google Search Central — JavaScript SEO basics
- Google Search Central — Fix JavaScript problems
- Google Search Central — Crawlable links
- Google Search Central — Lazy-loaded content
- Google Search Central — JavaScript structured data
- Google Search Central — Ecommerce site structure
- Google Search Central — Crawling errors and soft 404
כפיר אהרון, לולו דיגיטל
עוסק במשך שנים ב־SEO, CRO ו־PPC, ועבד עם עשרות אתרי איקומרס ובעלי עסקים בישראל. המאמר נבדק מול המקורות המופיעים בעמוד, ומפריד בין הנחיה רשמית, שיקול מקצועי ודוגמה היפותטית.